Context engineering uitgelegd: wat het is en waarom een goede prompt niet genoeg is
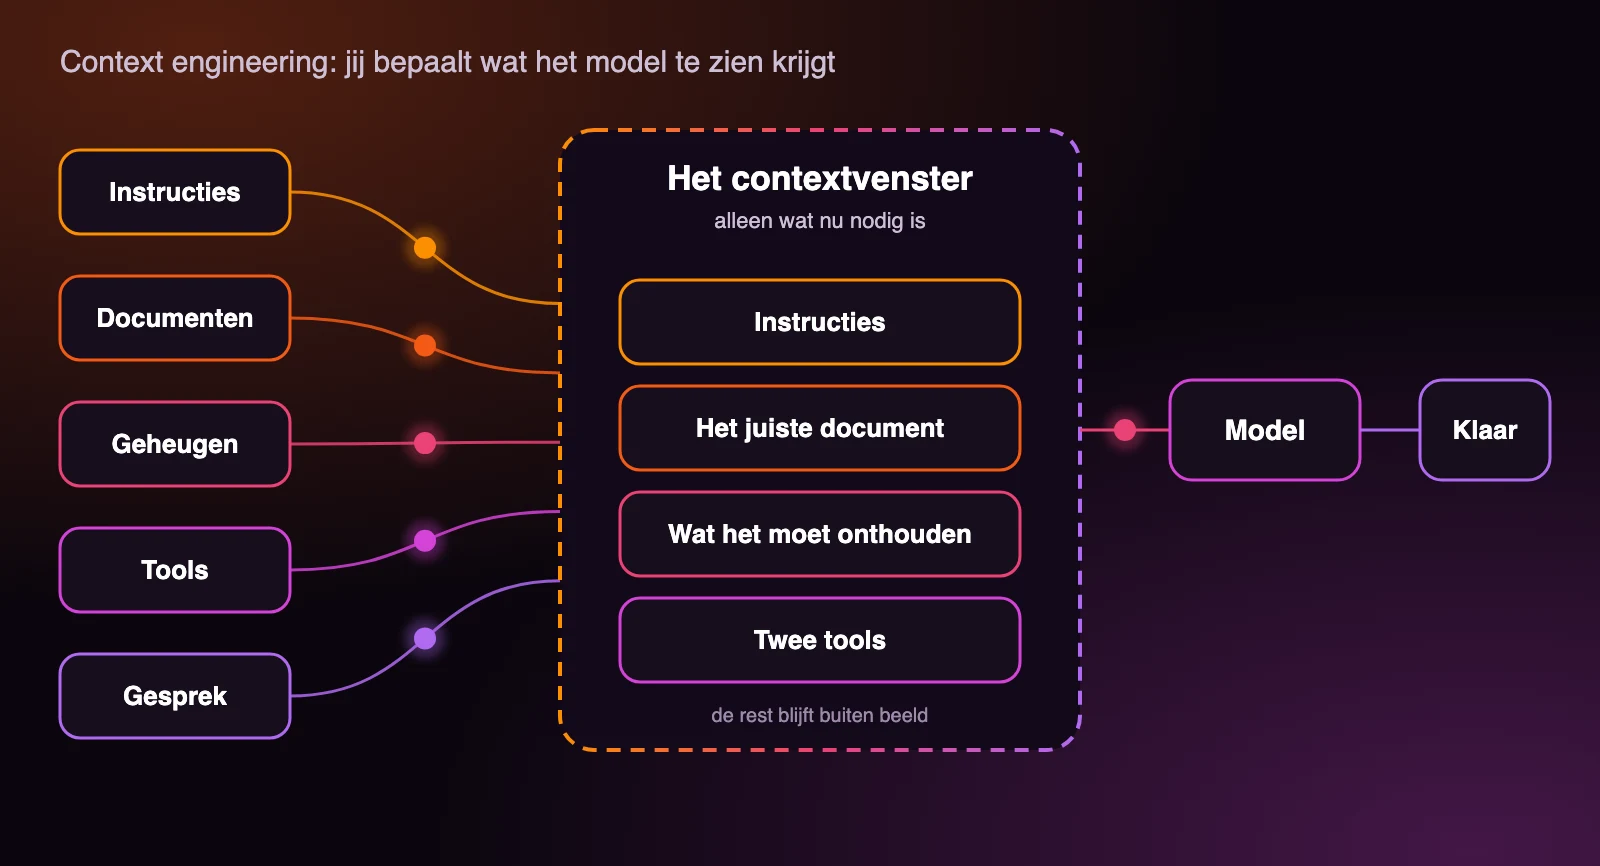
Context engineering is het kiezen van wat een AI-model te zien krijgt voordat het antwoord geeft: je opdracht, maar ook de tools, de voorbeelden, het gesprek tot nu toe, opgehaalde documenten en wat de agent heeft onthouden. In dit artikel lees je wat het is, waarom meer informatie in het venster vaak een slechter antwoord geeft, hoe het misgaat en wat je eraan kunt doen, ook als je zelf niet programmeert.
Je kent het misschien. Een AI-assistent doet het in het begin van een gesprek uitstekend. Na een uur werk vergeet hij afspraken, spreekt hij zichzelf tegen of herhaalt hij iets wat je al had afgewezen. Aan jouw prompt lag het niet. Er staat te veel in het venster waar het model mee werkt, en een deel daarvan hoort er niet meer in.
Daar gaat context engineering over. De term werd in juni 2025 populair en is sinds de uitleg van Anthropic in september 2025 een gangbaar begrip bij mensen die AI-agents bouwen. Hij heeft geen vaste definitie en een deel van wat eronder valt, zoals het ophalen van documenten, bestond al. Wat nieuw is, is dat het hele plaatje nu een eigen naam heeft. Stand van 9 november 2026.
Context engineering in het kort
Eerst de feiten op een rij.
| Onderdeel | Kort antwoord |
|---|---|
| Wat | Het ontwerpen van alles wat een AI-model per stap te zien krijgt: instructies, tools, voorbeelden, gesprek, opgehaalde gegevens en geheugen. Het doel is de kleinste set informatie die het gewenste antwoord het meest waarschijnlijk maakt. |
| Wanneer ontstond de term | In juni 2025. Shopify-topman Tobi Lütke zei dat hij de term beter vond dan prompt engineering, AI-onderzoeker Andrej Karpathy sloot zich daarbij aan met een eigen omschrijving. |
| Wie heeft het uitgewerkt | Anthropic publiceerde op 29 september 2025 een technisch artikel dat veel wordt aangehaald. Drew Breunig beschreef vier manieren waarop context misgaat en zes manieren om dat te herstellen. |
| Waarom het ertoe doet | Alle geteste modellen worden slechter naarmate de invoer langer wordt, ook ver onder de maximale lengte. Een agent die uren werkt vult zijn venster vanzelf met bijna alles wat hij tegenkomt. |
| Wat het niet is | Geen vervanging van prompt engineering en geen vast, gestandaardiseerd vakgebied. Het is ook geen reden om altijd meer informatie mee te geven. Vaak is het andersom. |
| Kernbronnen | Het artikel "Effective context engineering for AI agents" van Anthropic, het onderzoek "Context Rot" van Chroma (14 juli 2025) en de indeling van Drew Breunig. |
Wat context engineering is, in gewone taal
Stel je voor dat je een collega vraagt een klacht af te handelen, maar hij mag alleen werken met wat op één tafel past. Op die tafel liggen je instructies, de handleidingen van zijn programma's, een paar voorbeelden van goede antwoorden, het mailverkeer tot nu toe en de documenten die hij erbij heeft gehaald. Is de tafel vol, dan legt hij nieuwe stukken bovenop oude of schuift hij iets van de rand. Wat hij op dat moment ziet, bepaalt wat hij doet.
Voor een AI-model heet die tafel het contextvenster. Het model leest bij elke stap alles wat erin staat en niets anders. Anthropic noemt context daarom alles wat in de invoer zit, niet alleen de prompt. Dat is meer dan het klinkt. Zodra een agent met tools werkt, komt er bij elke stap iets bij: het resultaat van een zoekopdracht, de inhoud van een bestand, de foutmelding van een programma.
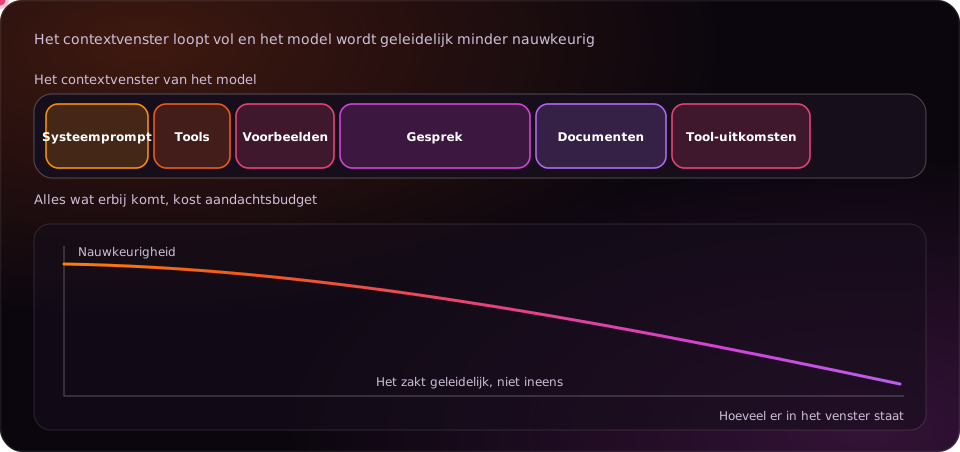
Zo'n venster rekent in tokens. Een token is een stukje tekst, ongeveer een woorddeel of een paar letters. Het venster is begrensd, maar belangrijker is dat het model zijn aandacht niet gelijk over alles verdeelt. Anthropic spreekt van een aandachtsbudget. Elk nieuw stuk tekst gebruikt een deel daarvan, en het budget is eindig.
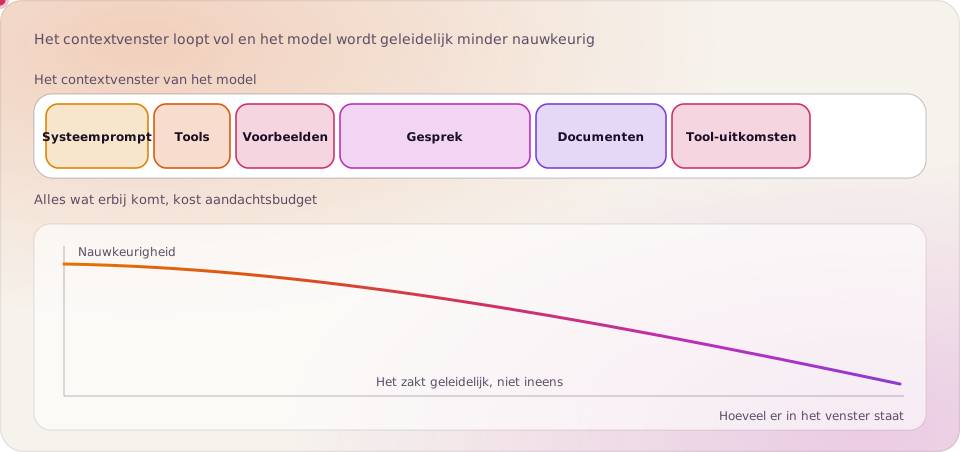
Context engineering is het werk om dat budget goed te besteden. Je bepaalt wat erin komt, in welke vorm, op welk moment en wat er weer uit gaat. Anthropic omschrijft het als de kleinste set informatie met veel signaal waarmee het gewenste resultaat het meest waarschijnlijk wordt.
Prompt engineering en context engineering: wat is het verschil
Prompt engineering is het goed schrijven van de instructie. Je kiest de woorden, de volgorde en misschien een voorbeeld. Dat blijft nuttig en het is een onderdeel van context engineering. Maar een prompt is één van de dingen die in het venster staan. Zodra een systeem meerdere stappen heeft, bepaalt het meeste van wat het model ziet iets anders dan jouw tekst.
Neem een assistent die klantvragen beantwoordt. De prompt zegt hoe hij zich gedraagt. De context bepaalt welke bestelling, welk stuk beleid en welke eerdere mail erbij worden gezocht, hoeveel van het gesprek blijft staan en welke tools de assistent mag gebruiken. Met een perfecte prompt en de verkeerde bestelling in het venster krijg je toch een fout antwoord.
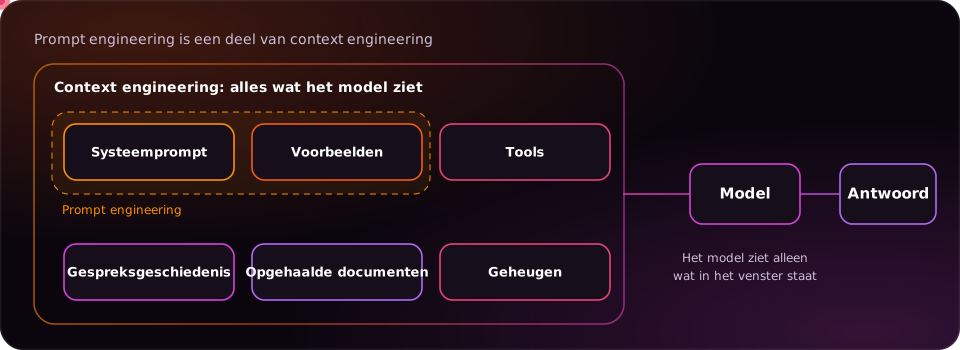
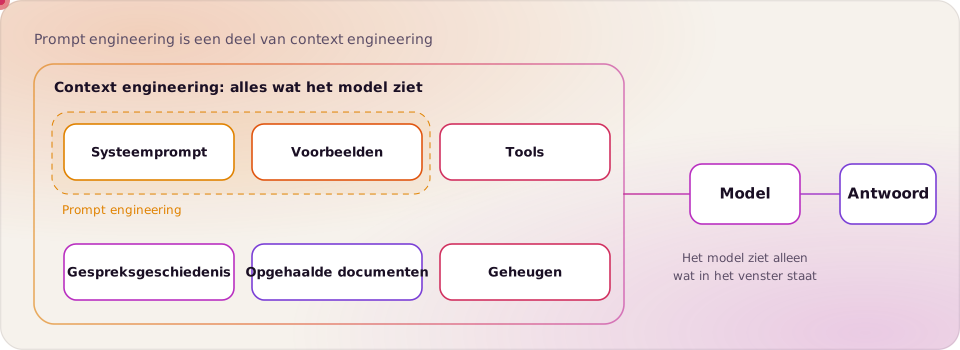
Er is nog een verschil in tijd. Een prompt schrijf je één keer en je verbetert hem daarna. Context stel je bij elke stap opnieuw samen. Anthropic noemt het daarom iteratief: elke keer dat het systeem beslist wat het model te zien krijgt, is dat een keuze die je ontworpen hebt of aan het toeval hebt overgelaten.
Waar de term vandaan komt en waarom hij omstreden is
In juni 2025 schreef Tobi Lütke, de topman van Shopify, dat hij "context engineering" een betere term vond dan "prompt engineering". Hij omschreef het vak als het leveren van alle context die nodig is om een taak redelijkerwijs oplosbaar te maken voor het model. Een paar dagen later reageerde Andrej Karpathy met steun voor de term en zijn eigen versie: de kunst en wetenschap van het vullen van het contextvenster met precies de juiste informatie voor de volgende stap.
Simon Willison, een veelgelezen schrijver over AI, voorspelde dat de term zou blijven hangen. Zijn redenering is dat een term vooral betekent wat mensen erin lezen. Bij "prompt engineering" denken de meesten aan tekst typen in een chatvenster, terwijl het vak ingewikkelder is. Bij "context engineering" ligt de bedoeling dichter bij het werk zelf. Op 29 september 2025 werkte Anthropic het uit in een eigen artikel, met als kern dat context een eindig en kostbaar goed is.
Er is kritiek. Een deel van de mensen vindt het een nieuwe naam voor iets wat al bestond: documenten ophalen, geheugen beheren, gesprekken inkorten. De verdediging is dat het geen herlabeling is maar een verbreding van de scope. Het gaat niet meer om één onderdeel maar om het geheel. Een eerlijke samenvatting is dat de term jong is, dat de meeste bronnen blogs en vakartikelen zijn en dat de onderliggende gedachte klopt, wat je ook van de naam vindt.
Waarom meer context vaak slechter werkt
Het is verleidelijk om een model alles mee te geven wat je hebt: het hele document, de hele mailwisseling, alle regels. Modellen hebben tegenwoordig vensters van honderdduizenden tokens, dus het past. Het onderzoek wijst een andere kant op.
Chroma publiceerde op 14 juli 2025 het rapport "Context Rot". Ze testten 18 modellen van onder meer Anthropic, OpenAI, Google en Alibaba, met bijna 195.000 aanroepen. Bij elk model werd het resultaat slechter naarmate de invoer langer werd, terwijl de opdracht even moeilijk bleef. In een van de proeven, over een gesprek, kregen de modellen dezelfde vraag eenmaal met ruim 113.000 tokens aan gesprek en eenmaal met alleen de ongeveer 300 tokens die ertoe deden. Elk model scoorde beter met de korte versie.
Twee andere uitkomsten zijn goed om te onthouden. Eén afleidend stuk tekst dat op het juiste antwoord lijkt, maakte de uitkomst al slechter, en met vier werd het erger. En een tekst die logisch opgebouwd is, bleek lastiger dan dezelfde tekst door elkaar geschud. Anthropic geeft als reden dat modellen elk stuk tekst met elk ander stuk in verband brengen en dat ze tijdens training vooral kortere teksten zagen. Het nadeel bouwt zich geleidelijk op, het is geen klif.
Dit noemen vakmensen context rot: de context verslechtert naarmate hij groeit. Voor jouw gebruik betekent het dat meer meegeven geen veilige keuze is. Elk stuk in het venster moet zijn plek verdienen.
Vier manieren waarop context misgaat
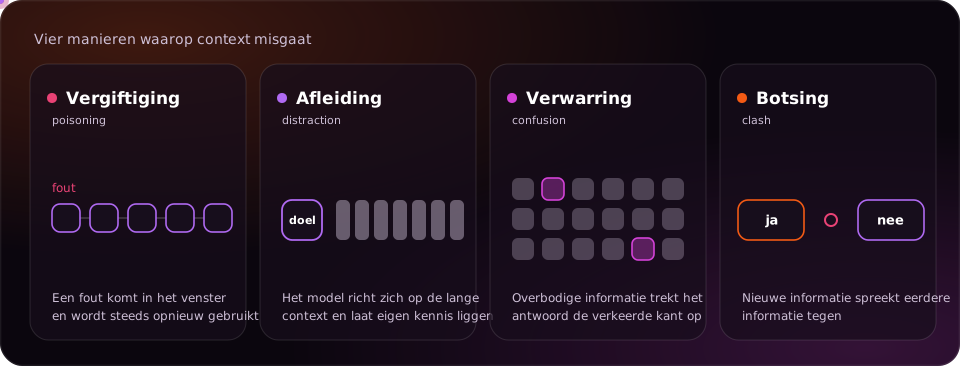
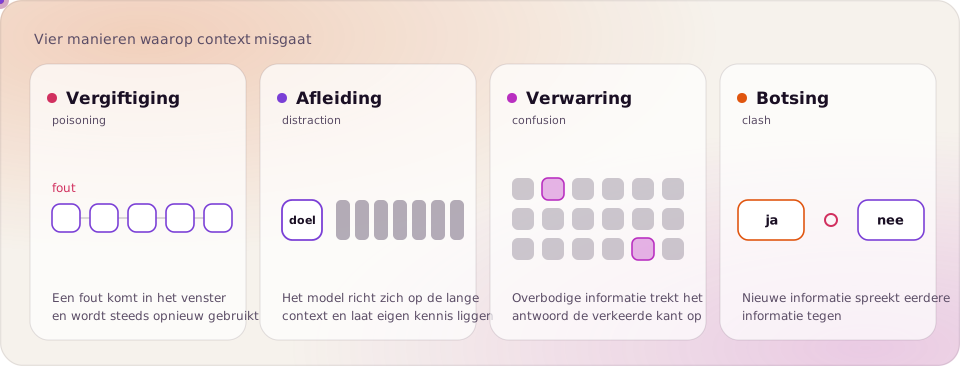
Drew Breunig, die veel over dit onderwerp schreef, onderscheidt vier faalpatronen. Ze komen vooral voor bij agents die lang werken en veel tools gebruiken.
Vergiftiging
Een fout of verzinsel komt in de context terecht en wordt daarna steeds opnieuw gebruikt. Stel dat de agent in stap drie een datum verkeerd noteert. In stap acht rekent hij ermee, in stap twaalf staat hij in het eindverslag. Omdat het model zijn eigen eerdere uitvoer als waarheid leest, herhaalt de fout zich zonder dat iemand hem nog opmerkt.
Afleiding
Een heel lange context kan het model te veel op de context zelf laten richten. Het blijft dan hangen in wat er al gebeurd is en laat zijn eigen kennis en de oorspronkelijke opdracht liggen. De agent gaat wat er in het venster staat herhalen in plaats van iets nieuws te bedenken.
Verwarring
Overbodige informatie trekt het antwoord de verkeerde kant op. Je geeft het model dertig tools mee en alleen twee passen bij de taak. Het kiest er een die er net naast zit, omdat de omschrijving erop leek. Wie zelf niet kan zeggen welke van twee tools hij zou pakken, mag van het model niets beters verwachten.
Botsing
Nieuwe informatie spreekt informatie uit het venster tegen. Een klant zegt in het begin dat het voor tien personen is en later dat het er twaalf zijn. Beide staan in de context. Het model kiest, middelt of vraagt niet door, en je weet niet welk van de drie je krijgt.
Zes manieren om de context gezond te houden
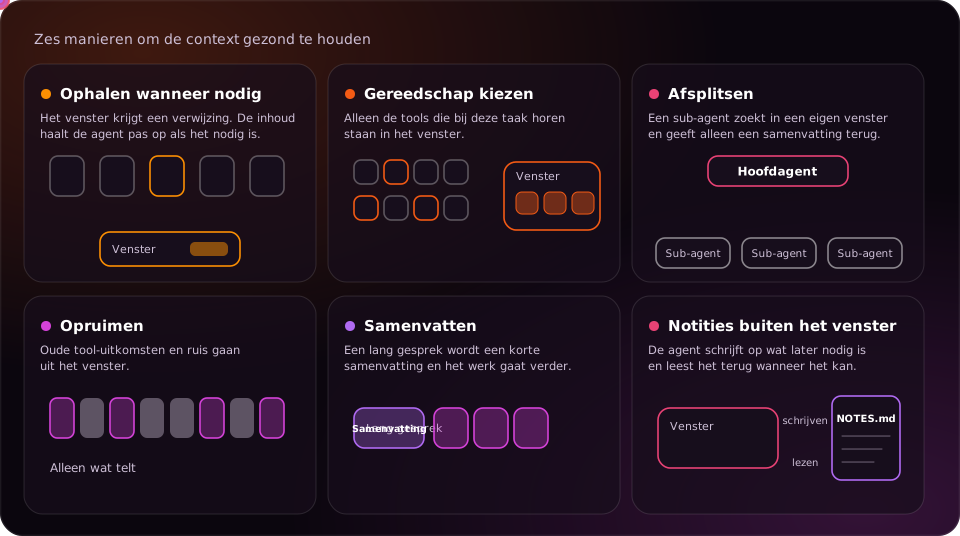
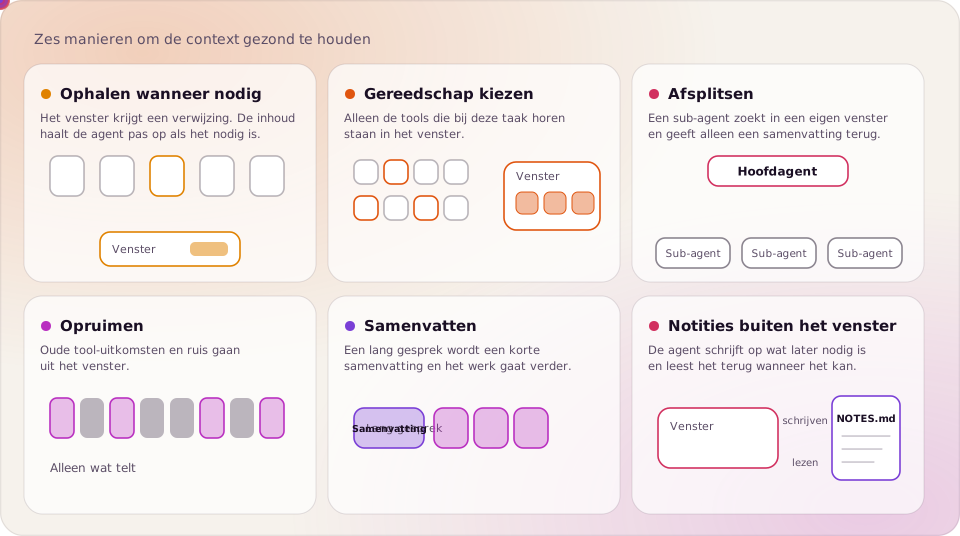
Voor elk van deze problemen bestaat een aanpak. Anthropic bespreekt er drie voor langlopende taken, Breunig noemt er zes. Hieronder staan ze in gewone woorden.
Ophalen wanneer nodig
Je zet niet alles vooraf in het venster. De agent krijgt verwijzingen, zoals bestandsnamen, zoekopdrachten en links, en haalt de inhoud op het moment dat hij hem nodig heeft. Anthropic noemt dit just-in-time. Claude Code werkt zo met grote bestanden en gegevens: het kijkt eerst met een zoekopdracht of de kop van een bestand en laadt niet het geheel. Het nadeel is dat het trager is en dat de agent goede aanwijzingen nodig heeft om niet te dwalen. Daarom combineren veel systemen beide: wat vrijwel altijd nodig is staat er vooraf in, de rest wordt op aanvraag opgehaald.
Gereedschap kiezen
Je geeft de agent alleen de tools die bij deze taak horen. Breunig wijst op onderzoek waarin sommige modellen in de war raakten bij meer dan twintig tools. Anthropic zegt hetzelfde op een andere manier: als een mens niet kan zeggen welke tool bij een situatie hoort, kan de agent het ook niet. Tools zonder overlap, met een duidelijke omschrijving, werken beter dan een grote gereedschapskist.
Afsplitsen
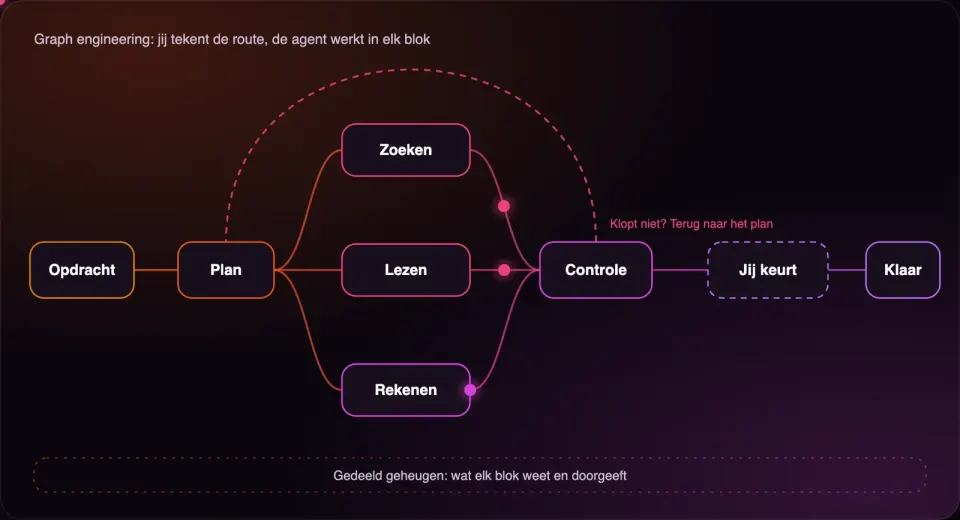
Een hoofdagent houdt het overzicht en stuurt sub-agents weg voor deelklussen. Elke sub-agent werkt in een eigen schoon venster, mag daar tienduizenden tokens aan zoeken en brengt alleen een samenvatting van zo'n 1.000 tot 2.000 tokens terug. Het zoekwerk blijft buiten het venster van de hoofdagent. Dit is een kleine graph en komt overeen met wat ik in het artikel over graph engineering beschrijf.
Opruimen
Wat niet meer nodig is, gaat eruit. De lichtste vorm is het wissen van oude uitkomsten van tools: de ruwe tekst die een zoekopdracht drie stappen geleden teruggaf, heeft de agent niet meer nodig als hij er een conclusie uit heeft getrokken. Breunig noemt dit pruning.
Samenvatten
Een gesprek dat bijna het venster vult, wordt samengevat en daarna begint het werk opnieuw met die samenvatting. Anthropic noemt dit compaction. In Claude Code blijven de samenvatting en de vijf laatst gebruikte bestanden staan. Het advies is om eerst te zorgen dat er niets belangrijks verloren gaat en pas daarna te schrappen wat overbodig is.
Notities buiten het venster
De agent schrijft op wat hij later nodig heeft, in een bestand buiten het gesprek, en leest het terug wanneer het kan. Dat kan een takenlijst zijn of een bestand als NOTES.md. In het voorbeeld van Anthropic hield een agent die Pokémon speelde zo precies bij waar hij was, ook na een reset van zijn venster. Breunig noemt het offloading.
Welke aanpak past, hangt van de taak af. Samenvatten past bij lange gesprekken met veel heen en weer. Notities passen bij werk met duidelijke tussenstappen. Sub-agents passen bij onderzoek dat je breed wilt uitzoeken en dan wilt samenvoegen.
Skills en progressive disclosure: de stand in 2026
Een patroon dat in 2026 veel terugkomt heet progressive disclosure, vrij vertaald: laat stap voor stap meer zien. Je legt niet het hele boek op tafel maar eerst de inhoudsopgave, en je slaat een hoofdstuk pas open als het nodig is.
Anthropic gebruikte dit op 16 oktober 2025 voor Agent Skills, kleine mappen met instructies en bestanden die een agent kan laden. Bij het opstarten leest de agent van elke skill alleen de naam en een korte omschrijving. Lijkt een skill relevant, dan leest hij de volledige instructies. Staan daar verwijzingen naar extra bestanden, dan opent hij die pas als de taak ze vraagt. Zo kan een skill veel meenemen zonder dat het venster daar vooraf vol van staat. Later is dit als open standaard gepubliceerd.
Een onderzoek van 20 juli 2026, "Is Progressive Disclosure All You Need for Long-Context Agents?", zet er een nuchtere kanttekening bij. De auteurs vergeleken verschillende opzetten bij vragen over lange documenten. Het voordeel hing af van het systeem eromheen: groot als de agent slecht door ruwe documenten navigeert, vrijwel nul als hij het zelf al goed kan. Eén niveau werkte goed. Een tweede routeringsniveau hielp nooit en deed soms veel kwaad. Hun conclusie past in één zin: progressive disclosure levert ruimte op, geen intelligentie.
Zo werk ik zelf met context
Ik gebruik Claude Code om aan de website en het beheerpaneel van Make it Matter te werken. Dat zijn veel bestanden en een lange geschiedenis, dus context is bij ons een dagelijks probleem. Wat ik daaraan doe is eenvoudig en past bij de principes hierboven.
Er is een bestand met werkafspraken dat bij elke sessie meekomt. Daarin staat waar welk onderdeel staat, wat wel en niet mag en welk document bij welke taak hoort. Per onderdeel is er een korte kaart die vanzelf geladen wordt zodra de agent een bestand van dat onderdeel aanraakt. Een kaart bevat de sleutelbestanden, de valkuilen en de tests, en niet de code zelf. Daarnaast is er een gegenereerd overzicht van alle bestanden met alleen de namen van de functies en een korte omschrijving.
De regel is dat de agent eerst de kaart en het overzicht leest, dan twee of drie bestanden kiest en alleen die opent, en bij grote bestanden alleen het stuk dat hij wijzigt. Breed zoeken over veel bestanden gaat naar een sub-agent die alleen de conclusie teruggeeft. Elk onderdeel krijgt een eigen sessie. Dat is ophalen wanneer nodig, afsplitsen en opruimen in een werkwijze, zonder er een ingewikkeld systeem voor te bouwen.
Begin klein: je eerste context ontwerpen
Je hebt geen agent-framework nodig om hiermee te beginnen. Het werkt ook voor een gewone chat met een model.
Schrijf op wat de taak minimaal nodig heeft om te slagen. Dat is je kern: de opdracht, de randvoorwaarden en één of twee goede voorbeelden.
Haal weg wat daar niet bij hoort. Controleer elk stuk tekst met de vraag of het antwoord slechter wordt als het wegvalt.
Geef verwijzingen in plaats van volledige documenten als het model kan terugvragen. Een lijst met bestandsnamen en een zin per bestand is een goed begin.
Splits een lange taak in delen en geef elk deel een eigen schoon gesprek. Neem alleen de uitkomst over naar het volgende deel.
Laat het model tussendoor opschrijven wat vaststaat, zoals beslissingen, open vragen en afspraken, en plak dat bij de start van een nieuw gesprek.
Test door dezelfde taak met minder context nog eens te doen. Is het resultaat gelijk of beter, dan hoorde dat deel er niet in.
Meer over agents lees je in wat agentic AI is en hoe je een AI-agent bouwt.
Wanneer context engineering niet loont
Voor een losse vraag in een chat is het overdreven. Een korte taak met een paar bronnen past in elk venster en heeft geen ontwerp nodig. Dat geldt ook voor een kleine verzameling documenten die je er gewoon in kunt zetten. Het onderzoek over progressive disclosure laat zien dat de winst klein is als het systeem het zelf al goed doet en pas groot wordt als er te veel is om door te lezen.
Houd ook rekening met de kosten. Elke laag die je toevoegt, zoals samenvattingen, sub-agents en notities, kan zelf fouten maken. Een samenvatting laat iets weg, een notitie kan achterhaald raken, een sub-agent kan het verkeerde terugbrengen. Begin met de kleinste ingreep en voeg iets toe als je ziet waar het misgaat. Anthropic schrijft zelf dat betere modellen minder voorschrijvend werk nodig hebben, dus wat nu nodig is, kan over een jaar overbodig zijn.
Veelgestelde vragen
Wat is context engineering?
Context engineering is het ontwerpen van alles wat een AI-model bij elke stap te zien krijgt: instructies, tools, voorbeelden, gesprek, opgehaalde gegevens en geheugen. Het doel is de kleinste set informatie die het gewenste antwoord het meest waarschijnlijk maakt.
Wat is het verschil tussen prompt engineering en context engineering?
Prompt engineering is het schrijven van de instructie. Context engineering omvat daarnaast alles wat verder in het venster komt en het moment waarop. De prompt is één onderdeel van de context.
Wat is een contextvenster?
Het contextvenster is alles wat een model bij één stap tegelijk kan lezen. Het wordt gemeten in tokens, stukjes tekst van ongeveer een woorddeel. Wat niet in het venster staat, bestaat voor het model op dat moment niet.
Wat is context rot?
Context rot is het verschijnsel dat een model slechter antwoordt naarmate de invoer langer wordt, ook ruim onder de maximale lengte. Chroma vond dit bij alle 18 geteste modellen. Het neemt geleidelijk toe, niet ineens.
Is een groter contextvenster beter?
Niet automatisch. Een groter venster biedt ruimte, maar elk extra stuk tekst gebruikt een deel van de aandacht van het model. Voor veel taken geeft een kleine, gerichte context een beter antwoord dan een volle.
Is context engineering hetzelfde als RAG?
Nee. RAG is het ophalen van passende documenten en die in het venster zetten. Dat is één manier om context samen te stellen. Context engineering omvat ook tools, geheugen, samenvatten en het opruimen van wat niet meer nodig is.
Heb ik context engineering nodig als ondernemer?
Als je af en toe een vraag aan een chatbot stelt waarschijnlijk niet. Zodra je AI laat werken aan terugkerende taken, zoals offertes, klantmails of onderzoek, en je ziet dat de kwaliteit tijdens een lange sessie zakt, loont het om te kijken wat er in het venster staat.
Bronnen
Effective context engineering for AI agents, Anthropic, 29 september 2025.
Context Rot: How Increasing Input Tokens Impacts LLM Performance, Chroma, 14 juli 2025.
Context engineering, Simon Willison, 27 juni 2025.
How to Fix Your Context, Simon Willison over het werk van Drew Breunig, 29 juni 2025.
Equipping agents for the real world with Agent Skills, Anthropic, 16 oktober 2025.
Is Progressive Disclosure All You Need for Long-Context Agents?, arXiv 2607.17598, 20 juli 2026.