Graph engineering uitgelegd: het verschil met prompts en loops
Graph engineering is het vooraf uittekenen van een AI-systeem als een netwerk van blokken en pijlen: welke stap doet wie, welke route mag het werk nemen, wat geven de stappen aan elkaar door en waar kijkt een controleur of een mens mee. Bij een prompt geef je één opdracht, bij een loop laat je het model zelf de volgende stap kiezen, bij een graph legt de ontwerper de route vast.
Je geeft een AI een grote opdracht in één keer: zoek twintig bedrijven, lees hun site, beoordeel of ze bij ons passen en schrijf er een mail bij. Het antwoord ziet er netjes uit en zit er net naast. Bedrijf zeven bestaat niet meer en bedrijf twaalf zit in een andere branche. Je weet niet in welke stap het misging.
In juli 2026 deed een vraag de ronde in de AI-wereld: gaan we nog over loops praten, of zijn we al bij graphs? Daar kwam de term graph engineering uit. Bijgewerkt op 15 oktober 2026. De term is drie maanden oud, heeft geen vaste definitie en is voor een deel een nieuwe naam voor iets wat al bestond. Dat bepaalt hoeveel je ervan mag verwachten.
Graph engineering in het kort
Eerst de feiten op een rij, per 15 oktober 2026.
| Onderdeel | Kort antwoord |
|---|---|
| Wat | Je tekent vooraf de stappen van een AI-systeem uit: blokken, pijlen, gedeeld geheugen, controles en menselijke akkoorden. Het model denkt binnen een blok, de route staat vast. |
| Wanneer ontstond de term | Rond 18 juli 2026, uit een discussie op X. Voorlopers dragen andere namen en zijn ouder (flow engineering, januari 2024). |
| Wie | Peter Steinberger stelde de vraag die de term op gang bracht, zonder definitie. In augustus 2026 volgde een overzichtsstudie met 35 auteurs. |
| Wat het niet is | Geen vast, gestandaardiseerd vakgebied. Het is ook niet automatisch hetzelfde als een kennisgraaf of als GraphRAG, en het betekent niet dat je meer agents moet toevoegen. |
| Waar het vandaan komt | Workflows, toestandsmachines en stroomschema's bestaan al tientallen jaren. Frameworks zoals LangGraph (januari 2024) bouwen ze voor AI-agents. |
| Kernbron | De arXiv-overzichtsstudie "Graph Engineering in the Era of LLM Agents" (21 augustus 2026) en de documentatie van LangGraph voor de bouwstenen. |
Wat graph engineering is, in gewone taal
Stel je twee medewerkers voor. De eerste krijgt de opdracht "regel de offerte voor deze klant" en bedenkt zelf wat daarvoor nodig is. Soms slaat hij de btw-controle over en merkt niemand het. De tweede krijgt een werkinstructie met een stroomschema: eerst de gegevens van de klant ophalen, dan de prijs berekenen, dan een collega laten controleren, dan pas versturen. Hij mag nadenken, maar alleen binnen zijn stap. De route ligt vast.
Graph engineering is de tweede werkwijze, voor AI. Het woord graph betekent hier gewoon een tekening van blokjes met pijlen ertussen, geen grafiek met assen. Je ontwerpt die tekening vooraf en het model werkt binnen de blokjes.
De bouwstenen zijn goed te volgen zonder programmeerkennis. Ze volgen de documentatie van LangGraph, het bekendste framework voor dit soort systemen, aangevuld met tutorials van derden.
Blokken (in vaktaal nodes). Een blok doet één taak. DataCamp geeft een nuttige test: kun je de taak beschrijven zonder het woord "en"? Zo niet, dan zijn het twee blokken.
Pijlen (edges). Een pijl zegt welk blok na welk blok komt. Sommige pijlen liggen vast. Andere zijn voorwaardelijk: een kleine routeerfunctie kijkt naar wat er tot dan toe is gebeurd en kiest de volgende pijl, of stopt.
Gedeeld geheugen (state). Alle blokken lezen en schrijven in hetzelfde logboek: de opdracht, de gevonden bronnen, het concept, de opmerkingen van de controleur. Wat een blok doorgeeft, staat daar. Wat er niet staat, weet het volgende blok niet.
Parallelle takken. Drie blokken kunnen tegelijk werken en hun resultaat daarna samenvoegen.
Een aparte controleur. Een blok dat niet zelf schrijft, maar alleen kijkt of het resultaat klopt. DataCamp noemt dit meestal het waardevolste blok in de hele graph.
Een menselijke poort. De graph pauzeert en wacht tot jij akkoord geeft. Daarvoor bewaart het systeem na elke stap een tussenstand (een checkpoint).
Een maximum aan herhalingen. Als de controle blijft twijfelen, loopt de graph rondjes. Een limiet voorkomt dat dit eindeloos doorgaat en geld kost.
Er is nog een verwarring die je moet kennen. Een taakgraaf beschrijft hoe werk verloopt. Een kennisgraaf beschrijft wat bekend is, met bedrijven, personen en de relaties daartussen. Beide heten graph en ze zijn niet hetzelfde. DataCamp en AI Builder Club zeggen uitdrukkelijk dat graph engineering niet over kennisgrafen of GraphRAG gaat. Dit artikel gaat over de taakgraaf.
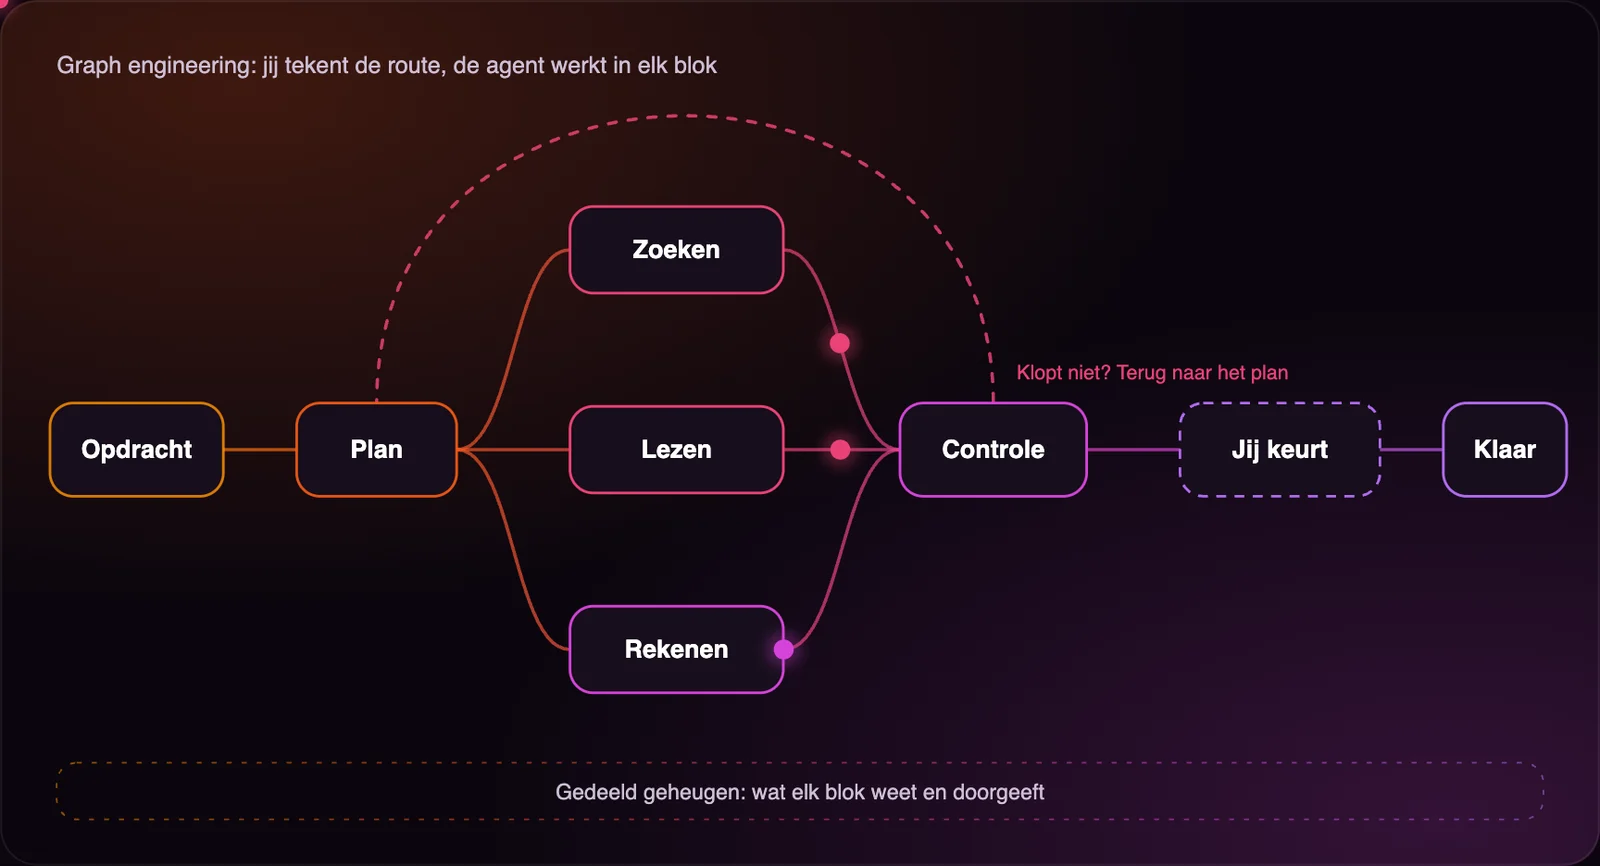
Figuur 1 laat zo'n taakgraaf werken. Een opdracht komt binnen en gaat naar een plan. Daarna splitst het werk zich in drie blokken die tegelijk bezig zijn: zoeken, lezen en rekenen. Bij de controle komt alles samen. Twijfelt de controle, dan loopt het werk terug naar het plan. Keurt de controle goed, dan gaat het naar jou, en pas na jouw akkoord naar het resultaat.
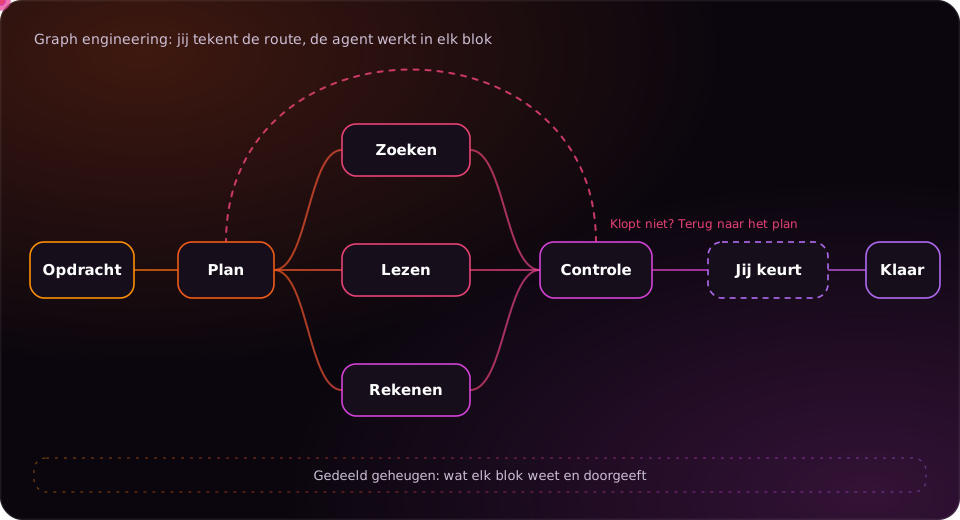
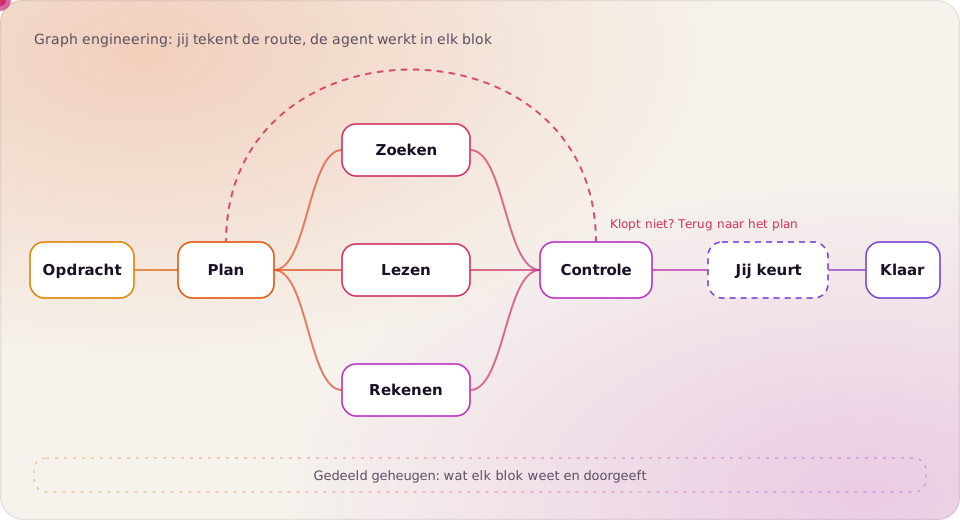
Het model kiest hier geen route. Het schrijft en leest binnen de blokken, en de pijlen bepaalt de ontwerper. Gaat er iets mis, dan kijk je in het gedeelde geheugen en zie je bij welk blok de fout binnenkwam. Dat is het grootste praktische voordeel ten opzichte van de grote opdracht in één adem.
Prompting, loops en graph: wie bepaalt de volgende stap
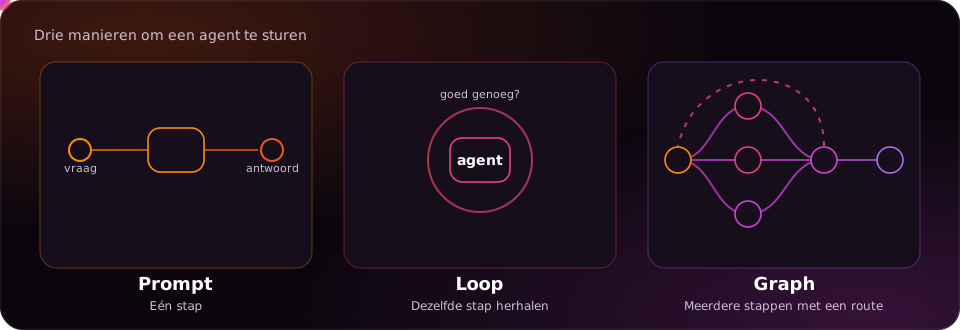
Bronnen als Design Gurus, Future AGI en PALO IT komen steeds op dezelfde vraag uit: wie beslist wat de volgende stap is? Bij een prompt is er geen volgende stap, want je stelt één vraag en krijgt één antwoord. Bij een loop beslist het model onderweg: het probeert iets, kijkt naar het resultaat en bepaalt zelf de volgende zet, tot het vindt dat het klaar is of tot een limiet het stopt. Bij een graph beslist de ontwerper vooraf. Het model kiest hooguit tussen takken die jij hebt getekend.
De tabel zet de drie naast elkaar, in mijn eigen woorden.
| Prompt | Loop | Graph | |
|---|---|---|---|
| Wie kiest de volgende stap | Niemand, er is één aanroep | Het model, tijdens het werk | De ontwerper, vooraf |
| Wat jij ontwerpt | Instructies, voorbeelden, het formaat van het antwoord | Gereedschap, budgetten, stopregels, controles | Blokken, pijlen, gedeeld geheugen, voorwaarden |
| Geheugen | Geen | Binnen één run | Uitdrukkelijk, gedeeld, met tussenstanden |
| Hoe het meestal fout gaat | Een fout of slecht opgemaakt antwoord | Herhaalt een mislukte actie, stopt niet, of is zelfverzekerd fout zonder te crashen | Een tak faalt of krijgt het werk verkeerd toegewezen terwijl de totaalcijfers goed lijken, of er komt invoer binnen waar geen pad voor bestaat |
| Hoe je test | Voorbeeldvragen met goede antwoorden naast elkaar leggen | Hele trajecten beoordelen: doel, stappen en kosten, op vaste testtaken | Elk blok apart, dan de routering, dan het geheugen inspecteren, dan van begin tot eind |
| Kosten in aanroepen | Vrijwel vast: één aanroep | Wisselend: drie of dertig stappen, dus een plafond is nodig | Begrensd door het ontwerp, maar parallelle takken en herhalingen vermenigvuldigen het aantal |
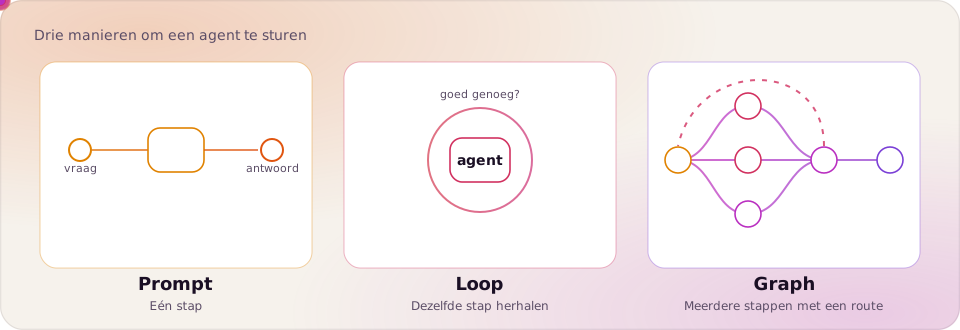
Figuur 2 zet dezelfde drie als plaatjes naast elkaar.
Een loop is de kleinste graph
AI Builder Club schrijft het letterlijk: een loop is de kleinste graph, een blok met een pijl naar zichzelf. Dale Everett zei het ook al. Formeel klopt het, en daarom roept de term kritiek op: als elke loop al een graph is, wat voegt het woord dan toe? Daarover straks meer. Praktisch vormen de drie een ladder: je begint onderaan en klimt pas als het moet.
Hoe elke aanpak faalt
Een prompt faalt zichtbaar: het antwoord is fout en je merkt het direct. Een loop faalt stiller. Addy Osmani, die in juni 2026 het essay Loop Engineering schreef, waarschuwt dat "klaar" een claim is en geen bewijs. Hij adviseert een aparte controleur, liefst met een ander model.
Een graph faalt op een derde manier. Het geheel ziet er goed uit terwijl één tak steeds fout werkt, of een soort invoer nergens past. Wie te vroeg bouwt, heeft veertig blokken terwijl één blok nog niet betrouwbaar was. Future AGI en Design Gurus rekenen voor dat een systeem dat per stap 95 procent haalt, over twintig stappen nog ongeveer 36 procent kans heeft dat alles goed gaat. Dat is een rekenvoorbeeld en geen meting, maar het laat zien waarom lange ketens een controle nodig hebben.
Hoe je ze test
Bij een prompt scoor je voorbeeldvragen. Bij een loop beoordeel je hele trajecten op doel, stappen en kosten. Bij een graph test je elk blok apart, dan de routering, en bekijk je het geheugen. Anthropic raadt aan uitkomsten te beoordelen en niet exacte stappen, en te beginnen met ongeveer twintig testvragen.
Wat het kost in aanroepen
Elk blok met een model erin is minstens één aanroep. DataCamp telt voor een schrijfgraph met drie blokken ongeveer drie aanroepen als de controle de eerste ronde goedkeurt en ongeveer vijf als ze afkeurt. Een enkele loop kost ongeveer één. Een vijfwegs-uitwaaiering met samenvoegen en drie herhalingen komt op vijftien of meer. Stel limieten in en noteer per blok het verbruik. Prijzen noem ik niet, die veranderen te snel.
Ze stapelen op elkaar
Je hoeft niet te kiezen. Een blok in een graph mag zelf een loop draaien: een zoekblok dat probeert tot het iets vindt, met een maximum. Binnen die loop zit weer een prompt. Future AGI beschrijft dit als lagen die op elkaar stapelen. De arXiv-studie zet ze in een ladder: prompt en context bij het model, harness en loop bij één agent, graph bij het hele systeem. Dat is de claim van de auteurs, geen vaststaande indeling.
Waar het vandaan komt en waarom de term omstreden is
De korte tijdlijn, voor zover ik de bronnen kon nalopen:
Januari 2024. Flow engineering, een voorloper, in een artikel over het programma AlphaCodium (arXiv 2401.08500). Ongeveer in dezelfde maand verschijnt LangGraph.
19 december 2024. Anthropic publiceert "Building effective agents". Het onderscheidt workflows, waarin vooraf bepaalde codepaden het model aansturen, van agents, waarin het model zelf de route kiest. Het advies: begin met de simpelste oplossing. De patronen die het beschrijft (ketenen, routeren, parallel werken) zijn in feite graphvormen onder andere namen.
7 of 8 juni 2026. Addy Osmani schrijft over loop engineering, met vijf bouwstenen plus geheugen en de waarschuwing dat "klaar" geen bewijs is.
18 juli 2026. Peter Steinberger vraagt op X of we nog over loops praten of al bij graphs zijn. Een andere bron noemt 17 juli. Het oorspronkelijke bericht kon ik zelf niet openen, dus ik vertrouw op bronnen die het beschrijven. Het was een vraag over woordgebruik en geen definitie. De term kwam uit de discussie erna. Dale Everett reageerde dat een loop al een eenvoudige graph is. Harrison Chase van LangChain zou hebben gevraagd of het niet gewoon LangGraph is. Dat geef ik bij benadering door, en zijn bedrijf maakt LangGraph.
21 augustus 2026. Een overzichtsstudie met 35 auteurs verschijnt op arXiv, "Graph Engineering in the Era of LLM Agents". Ze beschrijft expliciete en veranderlijke grafen van taken, agents en systeemtoestanden, in drie gezichtspunten: taakindeling, coördinatie en beheer van de toestand. Dit komt uit de samenvatting, de rest van de studie las ik niet.
De kritiek
De kritiek is serieus en ik deel een groot deel ervan.
Het is een nieuwe naam voor bestaande praktijk. Toestandsmachines, stroomschema's en workflow-engines doen dit al tientallen jaren. PALO IT noemt het grotendeels een nieuwe naam voor orchestration. DataCamp noemt de term een nuttige verkorting, geen noodzaak.
De term is overladen. Sommigen bedoelen een taakgraaf, anderen een kennisgraaf. Ook de schaal verschilt: een paradigma voor hele systemen in de studie, een handvol blokken in de blogs.
Veel bronnen zijn vendor-blogs. Virale claims, zoals dat graph engineering bij een groot bedrijf RAG verving, vond ik nergens onderbouwd. Een gemeld getal van 18 procent nauwkeuriger en 85 procent goedkoper komt uit een studie over industriële diagrammen. Vraag bij elke winst welk soort graph het was en waarmee het vergeleken is.
De winst is vaak klein. Een onderzoeksgroep van Berkeley (arXiv 2503.13657) bekeek ruim 1.600 sporen van zeven frameworks voor meerdere agents en beschreef veertien manieren waarop ze falen. De auteurs zien juist ruimte voor beter ontwerp. Anthropic meldde dat zijn systeem met meerdere agents 90,2 procent beter scoorde dan één agent op een interne test, een eigen meting van de leverancier, tegen ongeveer vijftien keer zoveel tokens als een chat. In een klein experiment van Analytics Vidhya was de graph ongeveer 6,0 seconden sneller dan de loop, zonder betere nauwkeurigheid.
De verdedigers zeggen dat de architectuur echt en nuttig is, ook als de naam dat niet is. Een gedeelde naam maakt gesprekken makkelijker en sommige taken vragen om een vaste route, zoals goedkeuring door een mens bij onomkeerbare stappen. PALO IT geeft ook de tegenpositie: sommige taken zijn echt agentisch en dan is een vast pad forceren erger. Loops zijn eenvoudiger te draaien, te debuggen en terug te draaien, en elke handgeschreven tak haalt een beslissing weg bij het model en kan verouderen naarmate modellen beter worden.
Mijn lezing: de kritiek en de verdediging hebben allebei gelijk. De term is nieuw, het idee oud, en de tekening is een goede gewoonte.
Mijn botjes zijn een kleine graph
Ik werk zelf met een opzet die ik achteraf als graph kan duiden. Dit is wat ik doe, in mijn eigen woorden: "Ik laat de botjes bijvoorbeeld zoeken naar specifieke leads, heel specifieke eisen en vervolgens als er een match is pakt de stalker het op en gaat alle informatie achterhalen over het bedrijf. Daarna geeft de analyst een kansen inschatting en de head of desk geeft mij alle uitgefilterde potentiele klanten die de moeite waard zijn voor ons om te benaderen."
Ik gebruik hiervoor Grok Bot, vanuit Nederland via Cursor Pro+, met vier botjes: scout, stalker, analyst en head of desk. Over Dots van OpenAI schreef ik eerder, maar die heb ik niet gebruikt. De twee staan naast elkaar in mijn vergelijking.
Als ik de termen volg, is dit een kleine graph. Er zijn vier blokken, met elk een eigen taak. Er is een voorwaardelijke pijl: alleen als de scout een match vindt, gaat de stalker aan het werk. En er is een filter aan het eind: de head of desk geeft mij alleen de potentiële klanten die de moeite waard zijn. Dat is een duiding, geen bewijs dat ik graph engineering toepas. Ik gebruik geen LangGraph.
Wat ik eraan zie: het patroon geeft elk botje één werk. De scout hoeft niets te weten over analyseren en de analyst hoeft niet te zoeken. Het filter aan het eind bepaalt wat bij mij terechtkomt. Dat zegt iets over de opzet, niet over hoe goed ze werkt.
Wat ik niet weet, wil ik er eerlijk bij zetten. Ik weet niet hoe de botjes onderling overdragen: of ze een gedeeld geheugen gebruiken of elkaar iets doorsturen. Ik heb geen aantallen, geen resultaten en geen berekening van tijdwinst. Ik kan dus niet zeggen of dit beter werkt dan één bot met één lange opdracht. Ik beschrijf een herkenbaar patroon, geen meetresultaat.
Teken je eerste graph op papier voordat je iets bouwt
Je hoeft niets te programmeren om te beginnen. Pen en papier is genoeg, en op papier zijn fouten het goedkoopst te vinden. Mijn voorbeeld is een aanname en geen praktijkgeval: een klein bedrijf dat offerteverzoeken per mail beantwoordt. De bronnen geven geen mkb-cases. Ze geven wel principes, zoals een goedkeuringspoort bij onomkeerbare acties, een aparte controleur en limieten op herhalingen en kosten. Die pas ik toe.
Schrijf het doel in één zin. "Elk offerteverzoek krijgt binnen een werkdag een concept-antwoord met een prijsindicatie, dat ik kan nakijken."
Noem de blokken en geef elk een taak zonder "en". Bijvoorbeeld: lezen (wat vraagt de klant), uitzoeken (past dit bij ons aanbod), rekenen (de indicatie, in gewone code), schrijven (het concept) en controleren (klopt het met het verzoek).
Bepaal wat elk blok doorgeeft. Dat is het gedeelde geheugen. Schrijf per blok op wat erin moet komen: de samenvatting van het verzoek, de gevonden diensten, de berekende cijfers, het concept, het oordeel.
Zet een controle neer die niet door het schrijvende blok wordt gedaan. De controleur vergelijkt het concept met het oorspronkelijke verzoek en geeft alleen "goed" of "herzien" met een reden. Bij herzien gaat het terug naar het schrijven.
Zet een mens op elke onomkeerbare stap. Versturen, betalen en publiceren gaan nooit zonder jouw akkoord. In dit voorbeeld stuurt het systeem niets naar de klant. Het concept klaarzetten is het einde.
Stel een maximum aan herhalingen en een kostenplafond in. Bijvoorbeeld twee herzieningen. Daarna gaat het concept met een markering naar jou. Bepaal ook hoeveel aanroepen één verzoek mag kosten.
Test elk blok apart, dan de route. Geef het lees-blok tien echte verzoeken en kijk of de samenvatting klopt. Test daarna de routering met een verzoek dat nergens op lijkt, en pas dan van begin tot eind.
Begin met de kleinste versie. Misschien volstaat een vaste volgorde zonder terugkoppeling. Voeg een pijl toe als je een fout ziet die hij had kunnen voorkomen.
Voor veel taken in het mkb is een vaste workflow of één loop waarschijnlijk genoeg. Dat volgt uit het advies om simpel te beginnen, maar niemand heeft het voor het mkb getoetst.
Wil je dit met een AI-assistent doen, plak dan de volgende prompt in een gesprek en vul de punten tussen haakjes in:
Help me een graph op papier uit te werken voor deze taak: [beschrijf het doel in één zin]. Geef de blokken, met per blok één taak die je zonder het woord "en" kunt beschrijven. Geef per blok aan wat het uit het gedeelde geheugen leest en wat het erin schrijft. Geef aan welke pijlen vast zijn en welke voorwaardelijk. Zet een aparte controleur neer die niet zelf schrijft. Markeer elke stap die niet terug te draaien is (versturen, betalen, publiceren) en zet daar een menselijk akkoord. Stel een maximum aan herhalingen voor en zeg welke blokken een model nodig hebben en welke gewone code kunnen zijn. Sluit af met de kleinste versie om mee te beginnen en met een eerlijk oordeel of een prompt of een enkele loop misschien genoeg is. Verzin geen gegevens en vraag door als iets onduidelijk is.
Wanneer een graph niet loont
Begin met de simpelste oplossing, zegt Anthropic, en voeg complexiteit alleen toe als die aantoonbaar iets verbetert. Design Gurus maakt er een ladder van: kies de laagste trede die werkt. Prompt, dan loop, dan graph.
Een prompt volstaat bij een volledig omschreven taak zonder opzoeken of acties.
Een loop volstaat als een agent met een paar gereedschappen zijn resultaat kan controleren en opnieuw proberen, als de stappen afhangen van wat het model onderweg ontdekt en als fouten goedkoop of terug te draaien zijn. PALO IT zegt: blijf bij een loop als de agent goede sensoren heeft, zoals tests.
Een graph loont bij aparte specialisten per stap, opzoekingen die tegelijk kunnen, een onafhankelijke controle, een mens die moet goedkeuren, of lange taken die je na een onderbreking wilt hervatten.
Soms is een graph zelfs overbodig. DataCamp geeft een voorbeeld: vijf blokken voor 800 hoteladressen, waar een kort script beter was geweest. Als alle stappen vooraf vaststaan, heb je geen model nodig om te routeren. Blokken die zonder verlies tot een loop samenvallen, moeten dat ook doen. Anthropic vindt meerdere agents ongeschikt als ze veel context delen, veel van elkaar afhangen of weinig te parallelliseren valt, zoals bij de meeste codeertaken.
Veelgestelde vragen
Wat is graph engineering?
Graph engineering is het vooraf ontwerpen van een AI-systeem als een netwerk van blokken en pijlen, met gedeeld geheugen, controles en menselijke akkoorden. De term dateert van juli 2026 en heeft geen vaste definitie.
Wat is het verschil tussen prompt engineering en graph engineering?
Bij prompt engineering schrijf je één goede opdracht voor één aanroep. Bij graph engineering ontwerp je meerdere stappen en de route ertussen, en een prompt is dan de inhoud van één blok.
Wat is het verschil tussen graph engineering en loop engineering?
In een loop kiest het model onderweg zelf de volgende stap, tot het klaar is of een limiet het stopt. In een graph legt de ontwerper de route vooraf vast en kiest het model hooguit tussen getekende takken. Een loop is de kleinste graph.
Is graph engineering hetzelfde als LangGraph?
Nee. LangGraph is een framework van LangChain waarmee je zo'n graph kunt bouwen. Graph engineering is het ontwerpen zelf en kan ook met ander gereedschap of met gewone code.
Heb ik graph engineering nodig als ondernemer?
Waarschijnlijk niet als eerste. Begin met een prompt, ga naar een loop als de taak dat vraagt en gebruik een graph pas als je aparte stappen, een onafhankelijke controle of een menselijk akkoord nodig hebt. De bronnen geven geen mkb-cases, dit is een afleiding.
Wat is het verschil tussen een taakgraaf en een kennisgraaf?
Een taakgraaf beschrijft hoe werk verloopt: welke stappen, in welke volgorde, met welke controles. Een kennisgraaf beschrijft wat bekend is: bedrijven, personen en de relaties daartussen.
Is graph engineering een hype?
Voor een deel. De naam is nieuw en de praktijk oud, veel bronnen zijn vendor-blogs en de winst is wisselend. De vaste route, de controle en het menselijke akkoord zijn wel bruikbare ontwerpkeuzes.
Als je erover wilt praten
Zit je met een taak waarvan je niet weet of hij een prompt, een loop of een tekening met blokken nodig heeft? Ik denk graag mee. Plan een kennismaking via makeitmatter.studio.
Bronnen
Graph Engineering in the Era of LLM Agents: From Individual Intelligence to System Intelligence, arXiv 2608.21156, ingediend 21 augustus 2026.
LangGraph Graph API, LangChain, geraadpleegd 15 oktober 2026.
Building effective agents, Anthropic, 19 december 2024.
How we built our multi-agent research system, Anthropic, 13 juni 2025.
Loop Engineering, Addy Osmani, juni 2026.
Why Do Multi-Agent LLM Systems Fail?, arXiv 2503.13657, Berkeley, 2025.
Graph Engineering Guide, DataCamp, 24 september 2026.
Graph Engineering Guide 2026, AI Builder Club, 20 juli 2026.
Peter Steinberger's Loops or Graphs Tweet, AI Builder Club, juli 2026.
Prompt engineering vs loop engineering vs graph engineering, Design Gurus, 29 juli 2026.
Prompt, loop en graph engineering, Future AGI.
Loop and graph engineering, PALO IT.
Agent harness, loop en graph engineering, Analytics Vidhya, 4 augustus 2026.